ICML 2026 후기: 검증의 시대
2026년 8월 6일 · @gongsoonyee
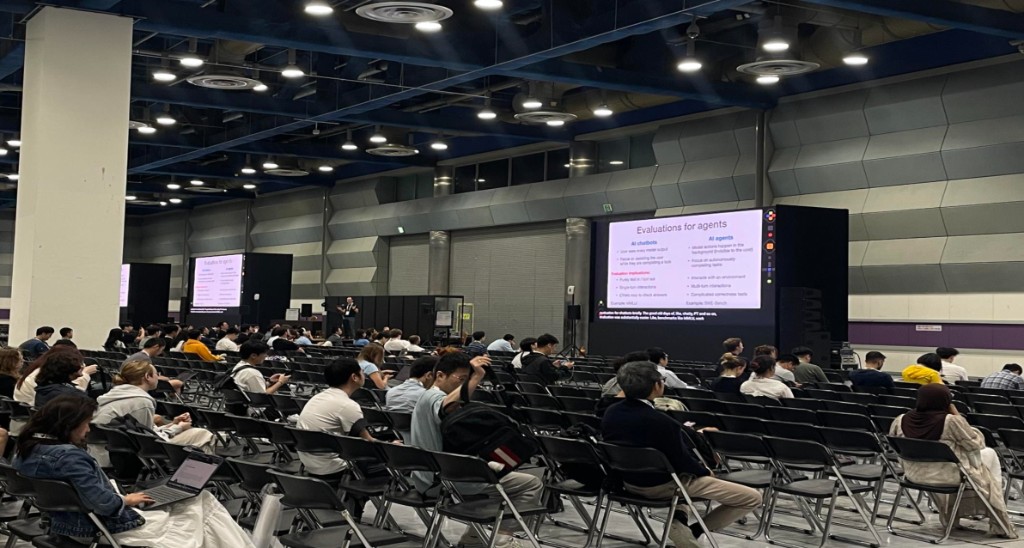
올해 ICML 2026에 다녀왔습니다. 행사 내내 머릿속에 남은 키워드는 “검증(Verification)”이었습니다. 리뷰 시스템, AI Scientist, 벤치마크까지, 거의 모든 논의가 “그래서 이걸 믿을 수 있나?”라는 질문으로 모였습니다. 현장에서 보고 들은 내용을 정리해 봅니다.
1. 숫자로 보는 ICML 2026
무엇이 늘었나
ICML 2026 탐색 도구(gisbi-kim.github.io/icml2026-explorer)로 키워드를 집계해 보면, 가장 많이 등장한 단어는 Benchmark(3,549)였습니다. 그 뒤를 Retrieval(2,204), Vision(2,129), LLM(2,009)이 이었습니다. Optimization(1,734), Theory(1,623), Robustness(1,576)도 꾸준히 많았고, Transformer(997), Agents(809), Multimodal(772), Diffusion(731), Fairness(658)가 그다음이었습니다.
토픽 기준으로는 LLMs and Generative AI(762편)가 1위였고, Large Language Models(593편), Data·Evaluation·Benchmarks(572편), RL and Agents(458편) 순이었습니다. 벤치마크와 평가가 상위권에 올라 있다는 점이 올해 분위기를 잘 보여줍니다.
제출 24,661편, 전년 대비 +98%
오프닝에서 가장 인상적이었던 슬라이드는 제출 수 그래프였습니다. 2017년 1,676편에서 시작해 2024년 9,473편, 2025년 12,468편을 거쳐, 올해는 24,661편으로 거의 두 배가 됐습니다. 그런데도 채택률은 그동안 21.5~28.0% 범위에서 크게 변하지 않았다고 합니다. 한마디로 리뷰 운영 자체가 병목이 된 해였습니다.
2. 달라진 리뷰 운영: LLM 리뷰 정책 실험
두 갈래의 정책
ICML 2026은 리뷰에서 LLM을 쓰는 문제에 대해 두 가지 정책을 나란히 운영했습니다.
Policy A(보수)에서는 리뷰의 어떤 단계에서도 LLM을 쓸 수 없습니다. 논문과 리뷰어는 서로 호환되는 정책끼리 매칭했고, 정책별 점수와 채택률 분포를 공개했습니다.
Policy B(허용)에서는 논문과 관련 연구를 이해하거나 리뷰 문장을 다듬는 데 LLM을 쓸 수 있습니다. 단, 장단점을 묻거나 리뷰 요점이나 개요를 제안받거나 리뷰 전체를 쓰게 하는 것은 금지입니다. 이와 함께 약 4,500편을 대상으로 사전 자동 피드백 도구를 시범 운영했는데, 사용한 저자의 73%가 유용했다고 응답했다고 합니다.
정책에 따라 결과가 달랐을까?
많은 사람이 정책마다 결과가 다를 거라고 예상했습니다. 실제로 Reddit에서 진행된 설문(약 100명 응답)을 보면, 체감 점수 분포는 Policy B 쪽이 더 높은 구간에 몰린 것처럼 보였습니다.
하지만 학회가 공개한 최종 결정 비율은 거의 같았습니다.
| 그룹 | Reject/Withdrawn | Accept(Regular) | Accept(Spotlight) |
|---|---|---|---|
| Policy A (n=7,041) | 73.7% | 23.9% | 2.4% |
| Policy B → A (n=1,686) | 73.0% | 24.4% | 2.6% |
| Policy B → B (n=15,191) | 73.4% | 24.5% | 2.1% |
정책에 따른 최종 결정의 차이는 사실상 없었습니다.
보이지 않는 워터마크
가장 말이 많았던 부분은 정책 위반 적발이었습니다. 학회는 PDF에 눈에 보이지 않는 확인용 문구를 넣어, 리뷰어가 논문을 통째로 LLM에 넣었는지 감지했습니다. 결과는 다음과 같습니다.
- LLM 사용이 확인된 리뷰 795건
- 데스크 리젝된 논문 497편
- 리뷰어 풀에서 제외된 인원 51명
적발된 리뷰어는 모두 Policy A에 동의했던 사람들이었습니다. 커뮤니티 반응은 “정당한 집행”과 “탐지 방식의 과잉”으로 갈렸습니다. 이 방식으로는 가장 부주의한 사용만 잡힌다는 한계도 지적됐습니다. 리뷰어의 공저자 논문까지 함께 리젝되는 부작용도 논란이 됐습니다. 워터마크 문구를 저자가 넣은 것으로 오해한 리뷰어가 저자에게 무결성 문제를 제기하며 최저점을 줬다는 사례가 Reddit에 올라오기도 했습니다.
3. Agent 연구 흐름
Main vs Workshop, 무엇에 집중했나
Agent 관련 논문(Main 35편 이상, Workshop 17편 이상 기준 분류)을 기여 축별로 같은 척도에서 비교해 보니 차이가 뚜렷했습니다.
| 기여 축 | Main | Workshop | 전체 |
|---|---|---|---|
| Execution Architecture | 41% | 30% | 35.7% |
| Efficiency & Resource Use | 33% | 18% | 25.3% |
| Evaluation & Verification | 27% | 22% | 24.2% |
| Long-Horizon Execution & Memory | 30% | 13% | 21.5% |
| Multi-Agent Configuration | 23% | 11% | 16.9% |
| Learning & Self-Improvement | 13% | 6% | 9.5% |
Main conference는 실행과 효율에, Workshop은 평가와 검증에 상대적으로 무게가 실렸습니다.
OMAC: 멀티 에이전트 시스템을 그래프로 최적화하기
인상 깊었던 논문 중 하나는 OMAC(Bi et al., 2026)입니다. 멀티 에이전트 시스템(MAS)을 고정된 팀이 아니라 그래프로 봅니다. 에이전트가 노드, 통신이 엣지이고, 컨트롤러가 그래프를 구성하는 구조입니다.
최적화 대상은 다섯 차원입니다.
- Fun-1: 기존 에이전트의 instruction prompt와 few-shot 예시 개선
- Fun-2: 현재 MAS에 필요한 새 역할의 에이전트 생성
- Str-1: 태스크에 맞는 에이전트 후보 팀 선택
- Str-2: 이전 출력을 바탕으로 매 스텝 참여할 에이전트 선택
- Str-3: 어떤 출력을 다음 에이전트의 context로 넘길지 결정
이 논문이 다른 점은 에이전트 수를 늘리는 데 있지 않습니다. 노드의 능력과 엣지·컨트롤러 설계를 하나의 최적화 문제로 묶었다는 점이 핵심입니다.
최적화 루프는 Contrastive 방식입니다. Semantic Initializer가 후보를 만들고, MAS에서 실행해 training set 성능을 측정합니다. 그다음 Contrastive Comparator가 잘된 후보와 안 된 후보 쌍을 비교해 성능 격차의 원인을 추론하고, 이를 바탕으로 후보를 다시 다듬습니다. 여러 차원을 다룰 때는 한 차원을 최적화해 best를 고정하고 다음 차원으로 넘어가는 식으로 번갈아 진행합니다.
결과도 꽤 좋았습니다.
- HumanEval: 85.74(DyLAN) → 89.25 (+3.51pp)
- MMLU: 70.06(AFlow) → 74.22 (+4.16pp)
- MATH: 32.49(AFlow) → 35.17 (+2.68pp)
여러 차원을 번갈아 최적화하면 효과가 더 커졌습니다. Fun-1.1과 Fun-1.2를 결합했을 때 정확도가 35.5%에서 42.0%로 올랐고, 상대 개선폭은 단일 차원의 2.9%에서 9.6%로 늘었습니다. 비용 효율도 좋아서, HumanEval에서 87.68% 정확도를 $0.0974로 달성했습니다(AFlow는 85.63%, $0.1134). 강한 차원을 먼저 골라낸 뒤 번갈아 최적화하는 전략이 중요하고, 여러 차원을 동시에 바꾸면 개선폭이 오히려 줄었다고 합니다.
4. Ask, Don’t Judge: 평가를 질문으로 쪼개기
평가 분야에서는 Ask, Don’t Judge가 기억에 남습니다. 아이디어는 단순합니다. LLM에게 점수를 통째로 매기게 하지 말고, 평가 기준을 먼저 명시한 뒤 이를 atomic Yes/No 질문으로 분해하자는 것입니다.
파이프라인은 다섯 단계입니다.
- 태스크 프롬프트에서 생성 요구와 제약 조건을 파악합니다.
- 명시적 평가 기준을 차원별로 정리합니다.
- 기준마다 이진 질문을 하나 이상 만들고, 복합 기준은 나눕니다.
- 질문마다 독립적으로 Yes/No를 판정하고 근거를 함께 생성합니다.
- 차원별로 집계해 전체 점수를 냅니다.
예를 들어 요약 평가라면 “요약이 원문의 핵심 주제를 다루는가?”, “불필요한 반복이 없는가?” 같은 질문으로 쪼갭니다.
사람과 닮은 점수 분포
이 방식(BinEval)의 가장 큰 장점은 점수 분포가 사람 판단과 비슷하다는 점입니다. G-Eval이나 UniEval은 점수가 천장 근처에 몰려 품질 차이를 잘 구분하지 못합니다. 반면 BinEval(Claude)은 Coherence, Consistency, Fluency, Relevance 네 차원 모두에서 사람 분포의 중심과 폭을 가장 가깝게 재현했습니다.
사례 연구도 흥미로웠습니다. 사실 오류가 여러 개인 요약에 사람은 2.0점을 줬습니다. BinEval은 7개 질문으로 잘못된 귀속과 날조를 잡아내 1.57점을 줬습니다. G-Eval과 UniEval은 그럴듯해 보인다는 이유로 5.0점 만점을 줬습니다.
Self-Improvement 루프
질문 단위로 판정하면 개선 신호를 얻기도 쉬워집니다. No 판정이나 모델 간 불일치를 lesson으로 바꾸고, 프롬프트의 관련 구간만 수정한 뒤 같은 질문으로 다시 검증합니다. 대부분의 개선은 1~2회 반복 안에 일어났습니다.
평가자(evaluator) 프롬프트를 업데이트했을 때의 결과는 다음과 같습니다.
- Spearman 상관 평균: self-update +.075, cross-model update +.070
- 가장 큰 개선: self-update에서 fluency +.119, cross-model에서 consistency +.136
- Relevance는 개선 없음(+0.000): 질문을 과도하게 분해하면 rubric만 더 엄격해짐
정리하면, 이진 분해는 구체적인 실패 유형에는 효과적이지만 relevance처럼 전체적으로 판단해야 하는 기준에는 한계가 있습니다.
생성기(generator) 프롬프트 업데이트(IFBench)에서는 더 뚜렷한 한계가 보였습니다. Self-update로 3회차에 38.0%(+3.4pp)까지 올랐다가 4회차에 26.1%로 무너졌습니다. 제약 유형별로 보면 Format과 Sentence는 각각 +17pp 개선됐지만, Count와 Ratio는 변화가 없었습니다. 프롬프트는 표현 방식은 고칠 수 있어도, 세기나 비율 계산 같은 능력 자체는 잘 바꾸지 못한다는 결론입니다.
5. 워크샵 후기
금요일과 토요일에는 워크샵 위주로 들었습니다.
Workshop 01: Deep Learning for Code
주제: Towards Human-Centered Coding Agents
코드를 잘 생성하는 것만으로는 부족하고, 평가와 최적화, 안정성, 개발자의 신뢰와 통제까지 함께 봐야 한다는 흐름이었습니다.
- ProgramBench: 프로그램을 처음부터 다시 만들 수 있는지 평가합니다. 9개 모델 모두 완전 해결 0%였습니다. 국소적인 버그 수정과 전체 재구성은 전혀 다른 문제라는 걸 보여줍니다.
- DevBench: 실제 개발자 상호작용에 기반한 코드 완성 벤치마크입니다. 최고 Pass@1이 43.5%였고, Pass@1 순위와 LLM-judge 순위가 일치하지 않았습니다. 실행된다고 유용한 것은 아니라는 뜻입니다.
- Coding With “Enemy”: 사람이 AI 에이전트의 sabotage를 알아챌 수 있는지 실험했습니다. 모니터가 없으면 94%가 탐지에 실패했고, 모니터가 올바르게 경고한 뒤에도 56%의 세션에서 sabotage가 남아 있었습니다.
- Hawkeye: 최소한의 감독으로 하드웨어를 고려한 GPU 커널 최적화를 합니다. 전략 분류 체계로 하드웨어 지식을 연결해 1.13×, 1.28×, 18.9× 수준의 개선을 보고했습니다.
코딩 에이전트는 “코드를 더 잘 짜는가”만으로 평가할 수 없습니다. 재구성 난이도, 사람의 감시, 평가 지표가 함께 발전해야 합니다.
Workshop 02: AI for Science
주제: AI Scientists — Tools, Co-authors, or Founders?
마침 학회 직후 경향신문(8월 4일자)에 AI가 수학 난제 풀이와 신약 개발 등 연구 현장으로 들어가고 있다는 기사가 실렸습니다. OpenAI, Google DeepMind, Anthropic이 모두 과학 연구용 AI에 힘을 쏟는 상황이라, 워크샵의 문제의식과 맞닿아 있었습니다.
워크샵의 핵심 질문은 “AI가 얼마나 많이 발견하는가”보다 “틀린 발견을 얼마나 빨리 드러내는가”였습니다.
- 검증과 감사: FabScore(자동 AI 연구의 날조를 세밀하게 평가), ReviewArena(여러 학회에 걸친 LLM 피어리뷰 데이터셋·벤치마크), Propose, Critique, Falsify(스스로 검증하는 AI Scientist 벤치마크)
- Agentic Science: ARA(에이전트 친화적인 연구 산출물), NMR Elucidation(NMR 구조 해석을 모델링이 아닌 에이전트 탐색 문제로 접근), OpenDiscoveryTrace(AI Scientist 워크플로를 평가하기 위한 과정 기록)
- 메커니즘의 충실성: Correct Answer, Wrong Mechanism(AI Scientist가 자기 데이터와 모순되는 일반적 주장을 옹호하는 문제), The Story is Not the Science(실행에 기반한 기계적 해석가능성 연구 평가)
이 밖에도 분야가 아주 다양했습니다. 과학 리뷰(ReviewArena, SciReview), 임상 시계열(OpenTSLM, HEARTS, SparseEHR), 에이전트 추론(DR Tulu, SIA-W), 과학적 머신러닝(Walrus, Origo, ChaosNexus) 등이 있었습니다.
트렌드를 묶으면 네 가지입니다. 생성보다 검증(FabScore, ReviewArena), Agentic Science(ARA, NMR Elucidation), 도메인별 Scientific Foundation Model(U-Cast, SparseEHR), 그리고 신뢰할 수 있는 평가(Correct Answer, Wrong Mechanism)입니다.
AI4Science 논문 1,461편과 연결 5,111개를 시각화한 인터랙티브 네트워크도 있으니 관심 있는 분은 둘러보세요. → paper-curation.jehyunlee.dev/ai4s-icml2026/network
6. 포스터 세션에서 눈에 띈 것들
메모리
- MemBoost: 이전 질의응답을 메모리에 저장하고, 가벼운 메타 컨트롤러가 메모리로 답할지 큰 LLM으로 넘길지 결정합니다. 비용을 고려한 추론 프레임워크입니다.
- E-mem: 장기 메모리를 압축 인덱스로 바꾸지 않고 원래 에피소드 맥락 그대로 보존합니다. 필요한 보조 에이전트만 활성화해 근거를 재구성하는 멀티 에이전트 구조로, LoCoMo 벤치마크에서 SOTA F1을 기록하면서 토큰 비용도 크게 줄였습니다.
Unlearning
- Position: The Term “Machine Unlearning” Is Overused in LLMs: 데이터셋 삭제, 출력 억제, 표현 난독화, 지식 편집, 행동 거부, 추론 시 필터링이 모두 “unlearning”이라는 한 단어로 불리고 있다고 지적합니다. 목표가 다르면 보장도 지표도 달라야 한다는 주장입니다.
- Forgetting Whenever You Want: 분산 환경에서 지속 학습과 요청 시 unlearning을 함께 다루는 프레임워크입니다. 원본 데이터 대신 prototype을 공유하는 방식입니다.
Policy
- Autoformalization of Agent Instructions into Policy-as-Code: 자연어 에이전트 지시문과 정책 문서를 generator-critic 루프로 Cedar 정책 코드로 자동 변환합니다. MedAgentBench에서 쓰기를 시도한 궤적의 98%를, 적대적 쓰기 시도는 100%를 차단했습니다.
마치며: ICML 2026 = Verification Era
올해 ICML을 한 줄로 요약하면 검증의 시대입니다.
- Review → Trustworthy Review
- AI Scientist → Trustworthy Scientist
- Benchmark → Trustworthy Evaluation
제출 수가 두 배가 되고 AI가 리뷰와 연구, 코딩 곳곳에 들어오면서, 이제 중요한 질문은 “무엇을 더 만들 수 있나”보다 “만들어진 것을 어떻게 믿을 수 있나”로 옮겨가고 있다고 느꼈습니다.